Claude Sonnet 5.5发布:性能逼近Opus 5.5,但“降本30%”需打问号
当地时间2026年9月28日,Anthropic正式发布Claude Sonnet 5.5,这是继9月22日Claude Opus 5.5之后,Claude 5.5家族的第二款模型。官方将其定位为“相比Sonnet 5的一次明确升级”,主打快速、高性价比的日常任务场景。
一、性能跃升:中端模型在编码测试中反超旗舰
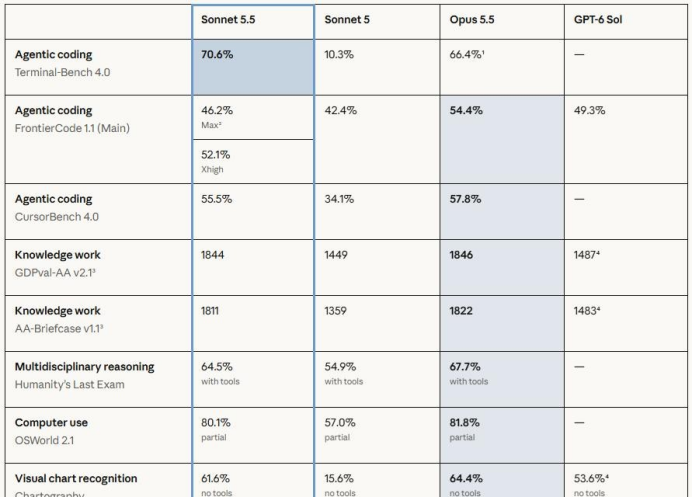
Sonnet 5.5在多项基准测试中的提升幅度显著。最引人关注的是智能体编程测试Terminal-Bench 4.0:Sonnet 5.5得分70.6%,远超上一代Sonnet 5的10.3%,同时也高于Opus 5.5的66.4%。
不过,这一“反超”需要更仔细地审视。Terminal-Bench 4.0衡量的是模型在命令行环境中自主调用工具完成任务的能力,Sonnet 5.5的优势集中在这一特定场景。在FrontierCode 1.1测试中,Sonnet 5.5在Xhigh档位得分52.1%,仍低于Opus 5.5的54.4%。在CursorBench 4.0中,Sonnet 5.5以55.5%落后于Opus 5.5的57.8%,差距约2.3个百分点。
在知识工作领域,GDPval-AA v2.1测试中Sonnet 5.5得分1844,与Opus 5.5的1846几乎持平,比Sonnet 5的1449高出近400分。Anthropic官方也明确说明:“在需要持续判断的复杂、开放式工作中,Opus 5.5仍然更强”。
在计算机操作方面,OSWorld 2.1测试中Sonnet 5.5得分80.1%,与Opus 5.5的81.8%接近,较Sonnet 5的57.0%有大幅提升。
二、成本争议:官方说省30%,实测说涨50%
Sonnet 5.5的API定价与上一代完全相同:每百万输入token 2美元、每百万输出token 10美元、缓存读取0.20美元。Anthropic官方称,由于完成同类任务所需token更少,单任务成本最高可降低30%。
然而,第三方数据和开发者实测呈现了不同的图景。
Artificial Analysis的榜单数据显示,Sonnet 5.5在最高推理档位下单任务成本为7.60美元,比Sonnet 5高出约50%,已接近Opus 5.5的7.63美元。Artificial Analysis指出,Sonnet 5.5单任务输出token数量明显更多,是导致成本上升的直接原因。
开发者实测也印证了这一趋势。BridgeMind使用Sonnet 5.5制作了一款射击游戏,构建成本达到177美元(约合人民币1187元),耗时49分钟。另有开发者实测WebGL小程序在max档位消耗12.8万token、花费1.28美元。
这一成本悖论的核心在于“推理档位”的选择。Sonnet 5.5提供了可调节的推理强度(effort level),Max档位赋予模型最高的推理自由度,但在部分场景中反而导致过度思考——频繁触发代码审查和子任务拆分,最终使任务超时或产生超出范围的修改。在FrontierCode测试中,Max档位得分46.2%反而低于Xhigh档位的52.1%,Anthropic也承认了这一现象。
因此,“降本30%”的前提是在合适的推理档位下执行边界清晰的任务。对于需要高推理强度的复杂任务,实际成本可能不降反升。
三、安全升级:首个配备前沿级网络安全保障的Sonnet
Sonnet 5.5在安全机制上有两项重要升级。
第一,网络安全能力已与Opus 5相当,是首个配备网络保障与回退机制的Sonnet模型。对于高风险的网络安全任务,模型会明确回退到Sonnet 5处理。
第二,新增防“推理提取”安全分类器,可检测并直接阻止试图提取模型内部推理过程的请求。该机制针对的是通过海量请求对模型进行蒸馏的攻击手法,即“工业化套取模型能力、绕开安全护栏”。被阻止的请求不会回退到其他模型,而是直接被阻断。
四、行业背景:Anthropic的密集发布与安全承诺的微妙变化
Sonnet 5.5的发布节奏值得关注。就在一周前(9月22日),Anthropic刚刚发布了Opus 5.5。而在此之前,公司CEO Dario Amodei曾多次公开强调AI安全的重要性。2026年2月,Anthropic更新了《负责任扩展政策》第三版,删除了此前“模型触及危险阈值就暂停训练”的硬性红线,改为“透明披露”的柔性框架。Anthropic在声明中表示,在竞争加剧、政府监管缺位的背景下,公司将不再恪守原有的暂停承诺。
与此同时,行业竞争持续升温。OpenAI近期发布了中端模型Sol和性价比款Luna增强版,Meta也推出了新的AI产品。Anthropic以“快、省、特定场景更强”的策略切入中端市场,Haiku 5.5也将在未来几周内发布,补齐高中低端全家桶。
五、选型建议
对于需要高频、快速迭代的开发场景,如日常代码补全、文档生成、bug修复,Sonnet 5.5是合适的选择。在Medium或High档位下,其成本效益较为明显。
对于需要持续判断的复杂推理任务,如大规模代码重构、跨系统架构设计,Opus 5.5仍然更为可靠。如果使用Sonnet 5.5处理此类任务,需要注意选择Xhigh而非Max档位,以避免过度思考带来的成本上升。
六、常见问题FAQ
Sonnet 5.5真的比Opus 5.5强吗?
不是全面超越。在Terminal-Bench 4.0这一特定测试中Sonnet 5.5得分更高,但在FrontierCode、CursorBench等多数基准测试中Opus 5.5仍然领先。Anthropic官方也明确表示Opus 5.5在复杂开放式工作中更强。
官方说的“降本30%”准确吗?
在边界清晰、推理档位适中的任务中,成本确实可以降低。但在需要高推理强度的复杂任务中,由于输出token更多,单任务成本可能比Sonnet 5高出约50%,接近Opus 5.5水平。
Sonnet 5.5的安全升级有哪些?
两项核心升级:一是首个配备与Opus 5同等级网络安全保障的Sonnet模型,高风险任务会回退到Sonnet 5;二是新增防推理提取分类器,直接阻断蒸馏攻击。
Haiku 5.5什么时候发布?
Anthropic表示将在未来几周内发布,面向高并发和成本敏感的应用场景。
推理档位怎么选?
日常任务建议使用Medium或High档位。复杂任务使用Xhigh而非Max,Max档位在部分场景中反而因过度思考导致成绩下降。
相关文章


 QQ群
 微信
 豫公网安备 41040202000300 号
评论