

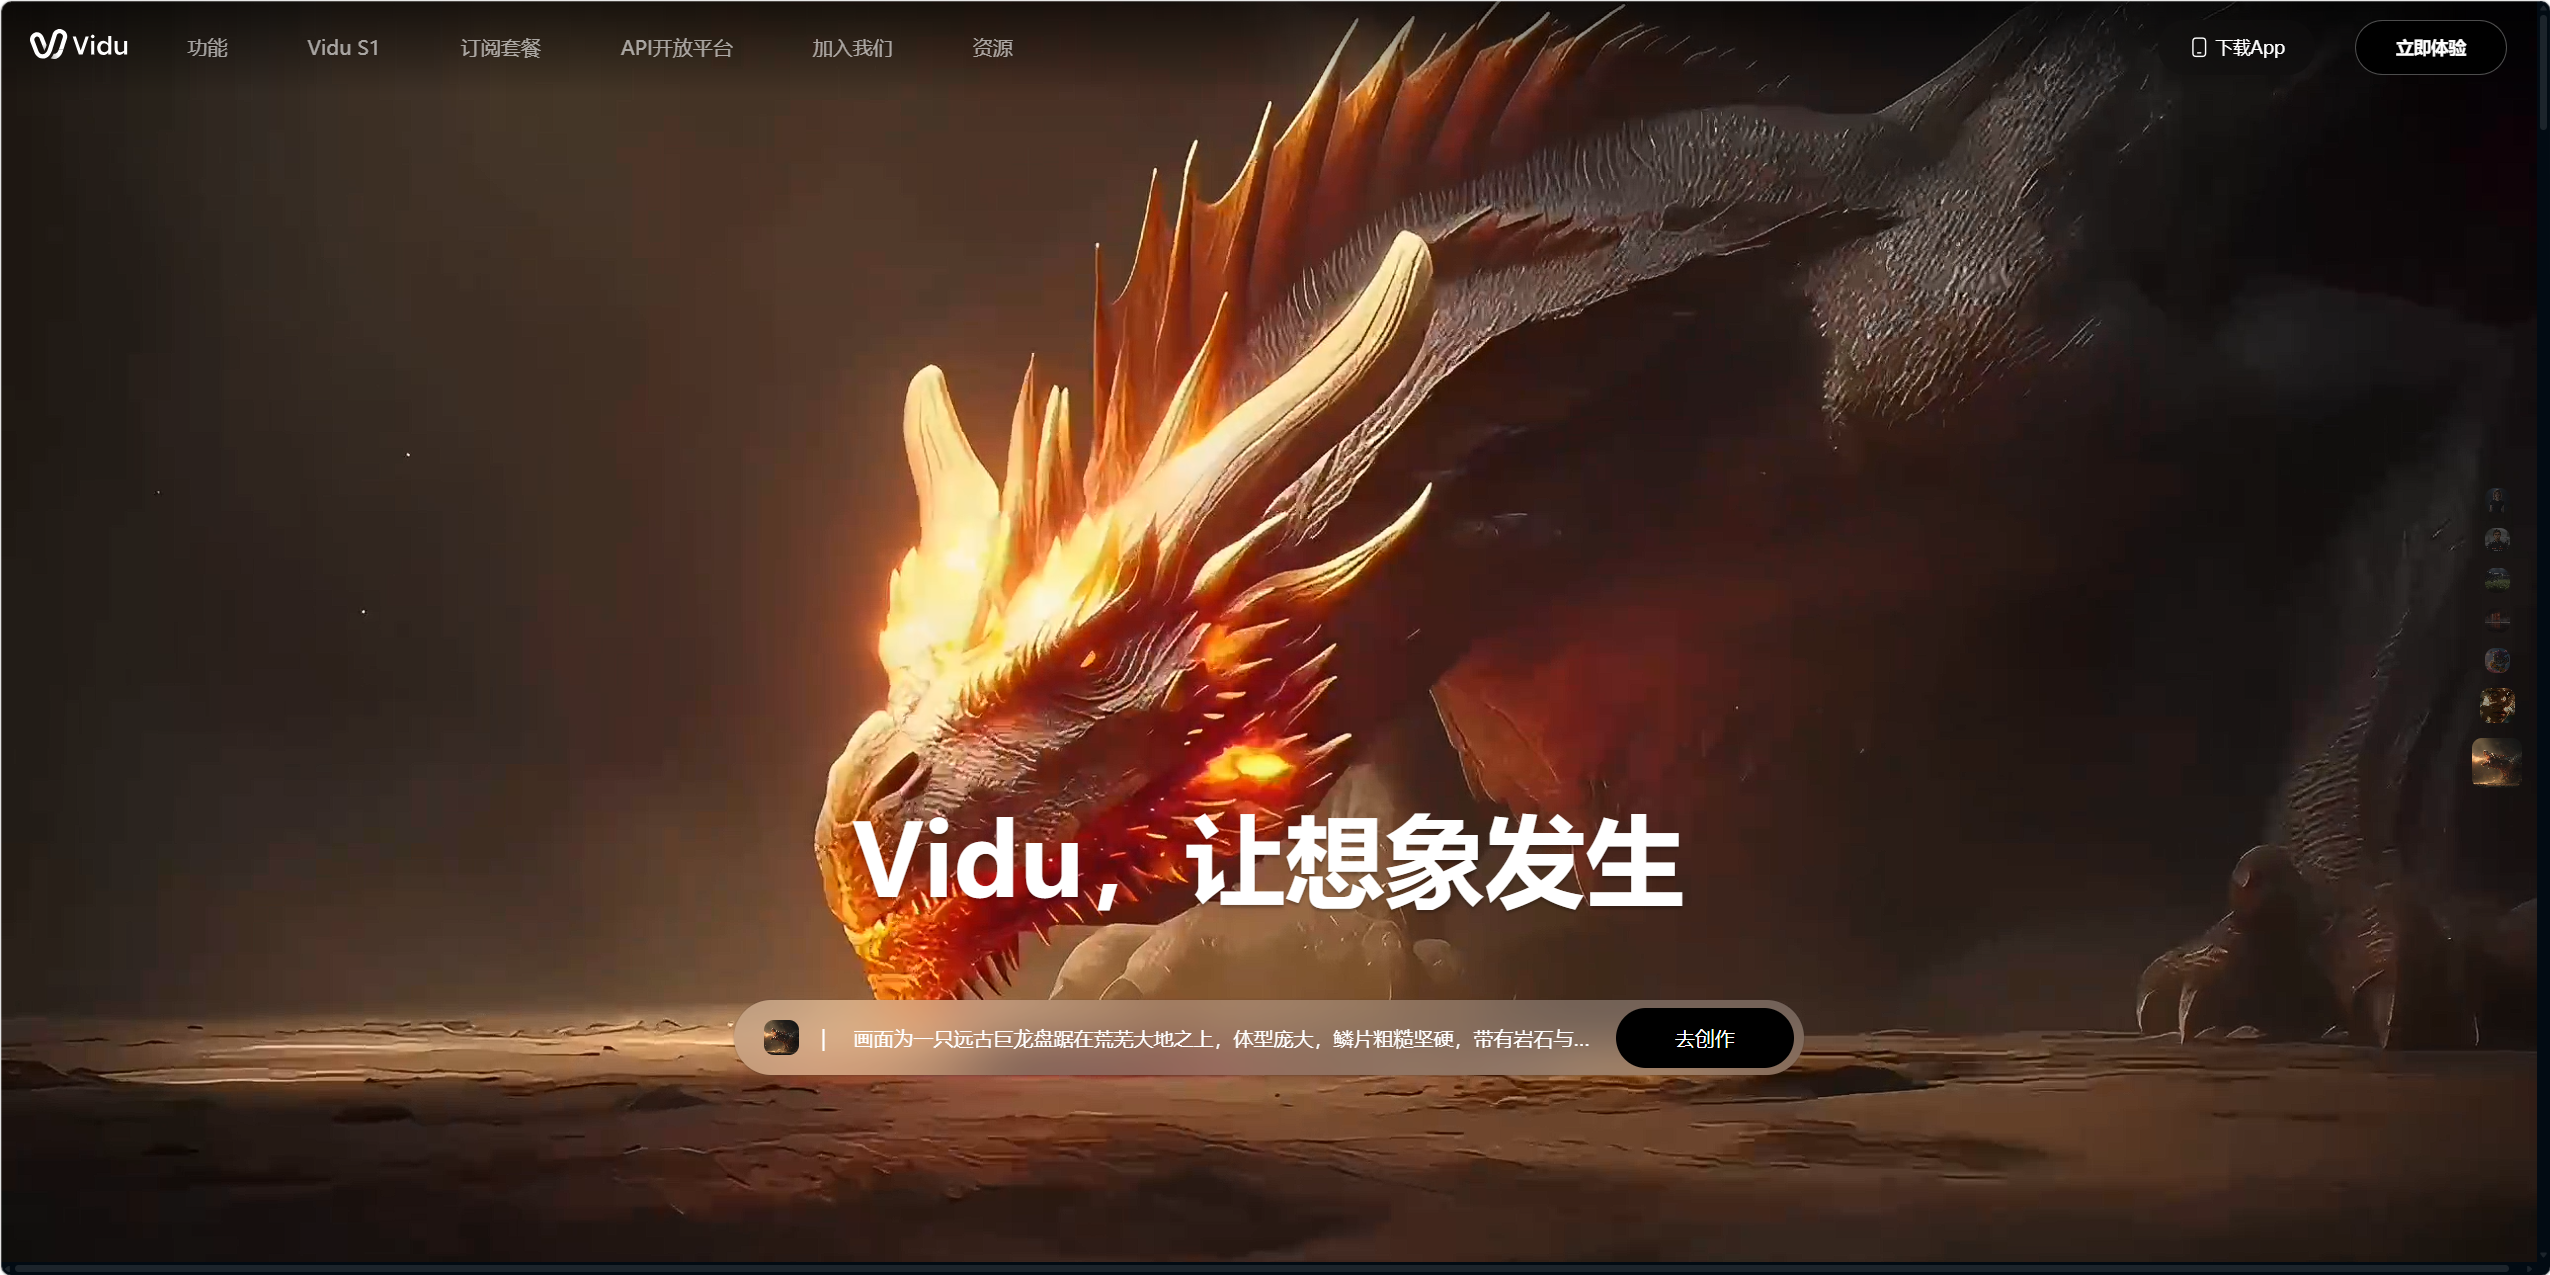
Vidu 是生数科技联合清华大学推出的中国首个长时长、高一致性、高动态性视频大模型,也是全球领先的 AI 视频创作平台。它集成了 Vidu Q2、Vidu Q3 等先进模型,支持图生视频、文生视频和参考生视频等多种创作模式,能够一次性同步生成画面、对白、环境音效与 BGM,让专业视频制作变得触手可及。
核心功能
文本转视频:用户只需输入文字描述,Vidu 便能将其转化为生动的视频内容,适合从零开始创造全新的视觉故事。
图片转视频:上传静态图片后,Vidu 可将其动态化,生成具有动画效果的视频,让创意瞬间“活”起来。
参考视频生成:这是 Vidu 的亮点功能。用户上传参考视频或图片,Vidu 能根据其风格、主体特征生成高度一致的视频内容,尤其适合需要保持角色或场景连贯性的创作。
多主体一致性:支持在一个视频中同时保持多个人物、物体或场景的一致性,解决了 AI 视频中常见的“角色串台”问题,适用于复杂叙事场景。
高质量视频输出:可生成时长最高达 16 秒、分辨率高达 1080P 的高清视频,画面细腻流畅。
AI 音效与模板:平台集成 AI 音效库,可为视频自动匹配或生成合适的音效。同时提供丰富的预设视频模板,一键套用,极大简化创作流程。
智能超清与参数配置:支持对已生成的视频进行自动修复和清晰度提升。用户还能自定义视频的风格、时长、运动幅度等参数,实现精细控制。
多镜头与风格生成:支持生成包含远景、近景、中景、特写等多种镜头的视频,带来丰富的视角和动态效果。同时支持写实和动漫等多种风格,满足不同审美需求。
中国元素理解:能深刻理解并生成具有中国特色的元素,如熊猫、龙等,为文化表达提供更丰富的视觉语言。
技术原理
Vidu 的技术核心是 U-ViT 架构,这是全球首个将 Diffusion(扩散)模型与 Transformer 架构融合的创新架构。这种融合让 Vidu 既拥有 Diffusion 模型强大的图像生成能力,又具备了 Transformer 处理复杂序列和长程依赖关系的优势。
在此基础上,Vidu 结合了多模态扩散模型 UniDiffuser,进一步验证了其架构在处理大规模视觉任务时的可扩展性。通过长视频表示与处理技术以及贝叶斯机器学习的优化,Vidu 能够生成更长、更连贯、物理规律更准确的视频内容。
适用人群
Vidu 凭借其强大的功能和易用性,适用于广泛的用户群体:
视频制作人员:包括电影制作人、广告创意人员、视频编辑,可利用 Vidu 快速生成创意视频内容或进行概念验证。
游戏开发者:可用于快速生成游戏背景、剧情动画或角色演示视频。
教育机构与教师:能够轻松制作教学视频、模拟科学实验或创建可视化教学内容。
科研人员:可用于模拟实验场景,帮助展示和讲解复杂的概念与过程。
内容创作者:社交媒体影响者、博主和独立制作者可以利用 Vidu 高效产出有吸引力的视频内容,提升创作效率。
定价与使用
Vidu 为所有用户提供免费积分,无需付费即可体验视频生成功能,这为新手和轻度用户提供了零门槛的尝试机会。对于有更高频率或更高质量需求的用户,平台提供不同档位的会员订阅服务,主要差异在于每月可用的积分数量、生成速度和视频分辨率等。用户可通过官网或 App 随时查看具体的定价方案。
类似网站


 QQ群
 微信
 豫公网安备 41040202000300 号
暂无评论