

LlamaIndex 是一个开源的数据框架,专为帮助开发者将大语言模型(LLM)与私有或领域特定数据连接而设计。它的核心使命是解决一个关键问题:如何让预训练于公开数据的大模型,能够有效利用用户自己的文档、数据库或API数据来回答问题、生成内容。经过数年演进,该项目已从早期的RAG编排工具,发展为以文档解析与提取为核心,并拥有企业级平台(LlamaParse)和开源工具包并行的生态系统。
LlamaIndex是什么
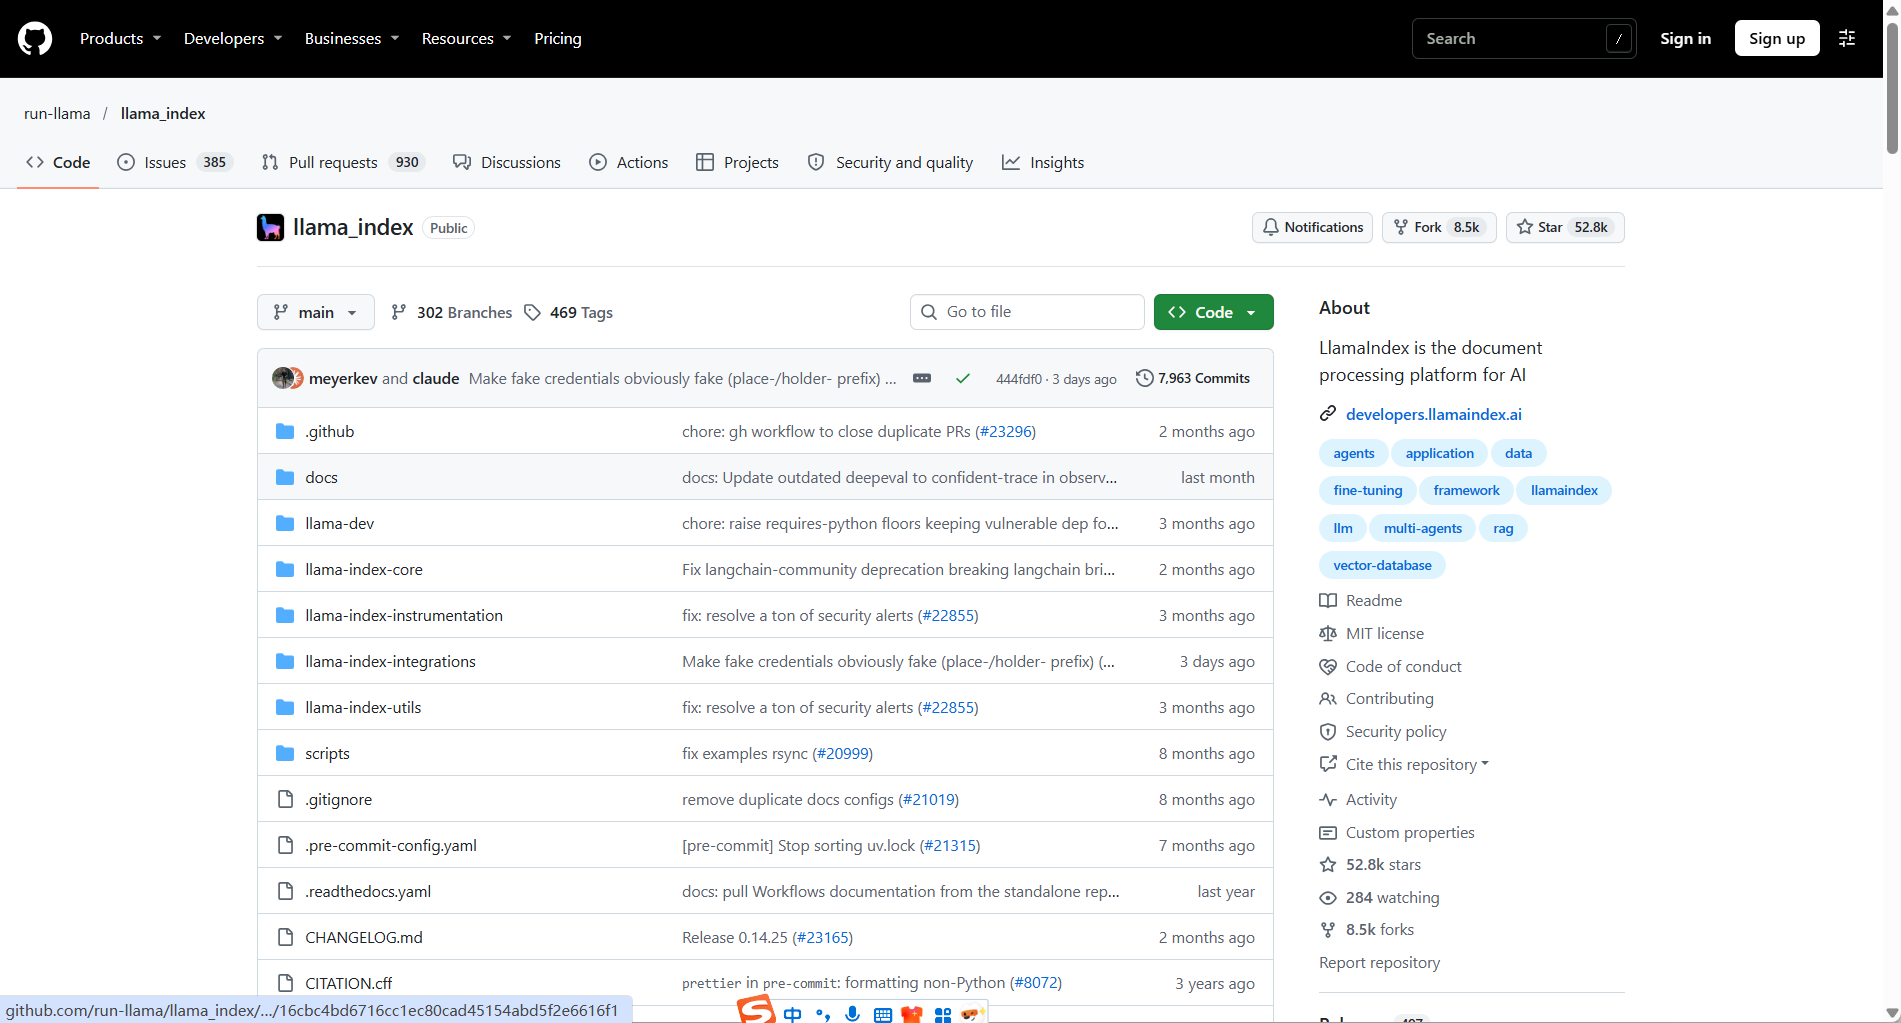
LlamaIndex 由 Jerry Liu 等人于2022年创立,最初名为 GPT Index。它是一个“数据框架”,为构建 LLM 应用提供了一套完整的工具链。其核心价值在于弥合大模型与私有数据之间的鸿沟:大模型本身不包含你的内部文档或业务数据,LlamaIndex 提供了摄取、结构化、索引和查询这些数据的能力,使开发者能基于自有数据构建问答系统、智能体(Agent)和检索增强生成(RAG)应用。
项目目前由 LlamaIndex 公司维护,公司的主要精力已转向企业级平台 LlamaParse,但开源框架 LlamaIndex 仍作为开放工具包持续维护和提供,两者可独立或配合使用。
LlamaIndex的主要功能
数据连接与摄取:提供超过300个集成包,支持从多种数据源(如 PDF、Word、Notion、SQL 数据库、API、Slack、Google Docs 等)加载数据。内置的 SimpleDirectoryReader 等工具可快速读取本地文件夹中的多种格式文件。
数据索引与结构化:将非结构化文档转化为 LLM 易于利用的结构化形式。核心索引类型包括向量存储索引(将文本块转换为向量后存入向量数据库)、摘要索引、关键词表索引和树状索引等,也支持知识图谱的构建。
高级检索与查询接口:提供多种检索策略,包括相似度检索、关键词检索、混合检索以及基于元数据的过滤。查询引擎可以接收自然语言问题,自动检索相关上下文并生成知识增强的回答。支持对检索结果进行重排序(Reranking)和后期处理。
Agent与工作流编排:内置 Workflows 和 Agent Builder,支持构建能够调用工具、执行多步推理的文档智能体。开发者可将检索、查询、工具调用等环节串联为自动化流程。
LlamaParse企业平台:这是 LlamaIndex 公司当前的核心商业产品,提供智能体式 OCR 和文档解析(支持130多种格式)、结构化数据提取、文档索引与 RAG 管道,以及大文档拆分和端到端文档智能体构建。该平台可独立使用,也可与开源框架配合。
如何使用LlamaIndex
安装:可选择安装包含核心和常用集成的起步包 pip install llama-index,或仅安装核心包 pip install llama-index-core 后按需添加集成包(如 llama-index-llms-openai、llama-index-embeddings-huggingface)。这种命名空间设计让开发者可以精确控制依赖。
基础流程:以构建一个向量索引为例,首先设置 API 密钥(如 OPENAI_API_KEY 环境变量),然后使用 SimpleDirectoryReader 加载文档目录,通过 VectorStoreIndex.from_documents(documents) 创建索引,最后用 index.as_query_engine() 生成查询引擎,调用 query_engine.query("你的问题") 即可获得基于文档的回答。
自定义模型:除了 OpenAI,开发者可通过设置 Settings.llm 和 Settings.embed_model 接入 Ollama 本地模型、HuggingFace 嵌入模型等,实现完全本地化或定制化的技术栈。
持久化存储:默认数据存在内存中,调用 index.storage_context.persist() 可将索引持久化到磁盘,之后通过 load_index_from_storage 重新加载。
LlamaIndex的核心优势
丰富的集成生态:超过300个集成包覆盖主流 LLM、嵌入模型和向量数据库,开发者可自由组合技术栈,避免被单一供应商锁定。
渐进式复杂度:高层 API 让新手能用约5行代码完成数据加载与查询;低层 API 允许高级用户自定义数据连接器、索引、检索器和查询引擎,适配从简单原型到复杂生产系统的不同需求。
数据框架的完整闭环:从数据摄取、结构化、索引、检索到查询和智能体编排,LlamaIndex 覆盖了构建私有数据 LLM 应用所需的核心环节,减少了在多个工具间拼凑的工作量。
企业级解析能力的延伸:LlamaParse 平台针对复杂文档(如财报、扫描件、表格)提供了智能体式 OCR 和结构化提取,弥补了开源框架在极端文档解析场景下的能力边界。
LlamaIndex的应用场景
企业知识库问答:将公司内部文档、Wiki、手册构建为可检索的索引,员工用自然语言提问即可获得基于内部资料的准确回答,避免大模型幻觉。
文档智能体与自动化工作流:构建能自动阅读合同、财报或研究论文的智能体,执行信息提取、摘要生成、多文档对比和报告撰写等任务。
RAG 应用开发:为聊天机器人、客服系统或搜索引擎添加检索增强生成能力,使回答基于最新、最相关的私有数据,而非仅依赖模型训练时的静态知识。
多模态文档处理:利用 LlamaParse 处理包含表格、图表和扫描内容的复杂 PDF,将非结构化文档转化为结构化数据,供后续分析或 RAG 管道使用。
类似网站


 QQ群
 微信
 豫公网安备 41040202000300 号
暂无评论