DeepSeek V4.1 Flash发布:CED非对称架构加持,Agent性能超越V4 Pro,KV Cache压缩437倍
9月10日,DeepSeek正式发布V4.1 Flash模型。作为全新CED(Causal-Encoder-Decoder)架构家族中体量最小的MoE模型,它在多项Agent基准测试中超越V4 Pro旗舰版本,同时带来原生多模态能力,借助KV Cache深度压缩与全新峰谷计费策略,大幅降低长会话、智能体任务的API使用成本。
一、全新CED非对称架构:输入输出差异化激活
V4.1 Flash整体骨干总参数达到552B,采用全新的Causal-Encoder-Decoder非对称架构。该架构为40层Transformer,前20层为因果编码器,后20层为解码器,实现输入输出阶段的差异化参数激活:处理输入时仅激活8B参数,生成输出时激活16B参数。
这种设计贴合AI Agent的真实工作模式:智能体运行过程需要读取海量历史对话、工具描述和项目源码,最终输出的指令和代码体量相对较小。编码器处理输入时激活参数更少,prefill计算复杂度从O(NL)降至约O(NL/2),接近减半。MoE层面,每层配置1个共享专家和384个路由专家,每token激活6个专家。
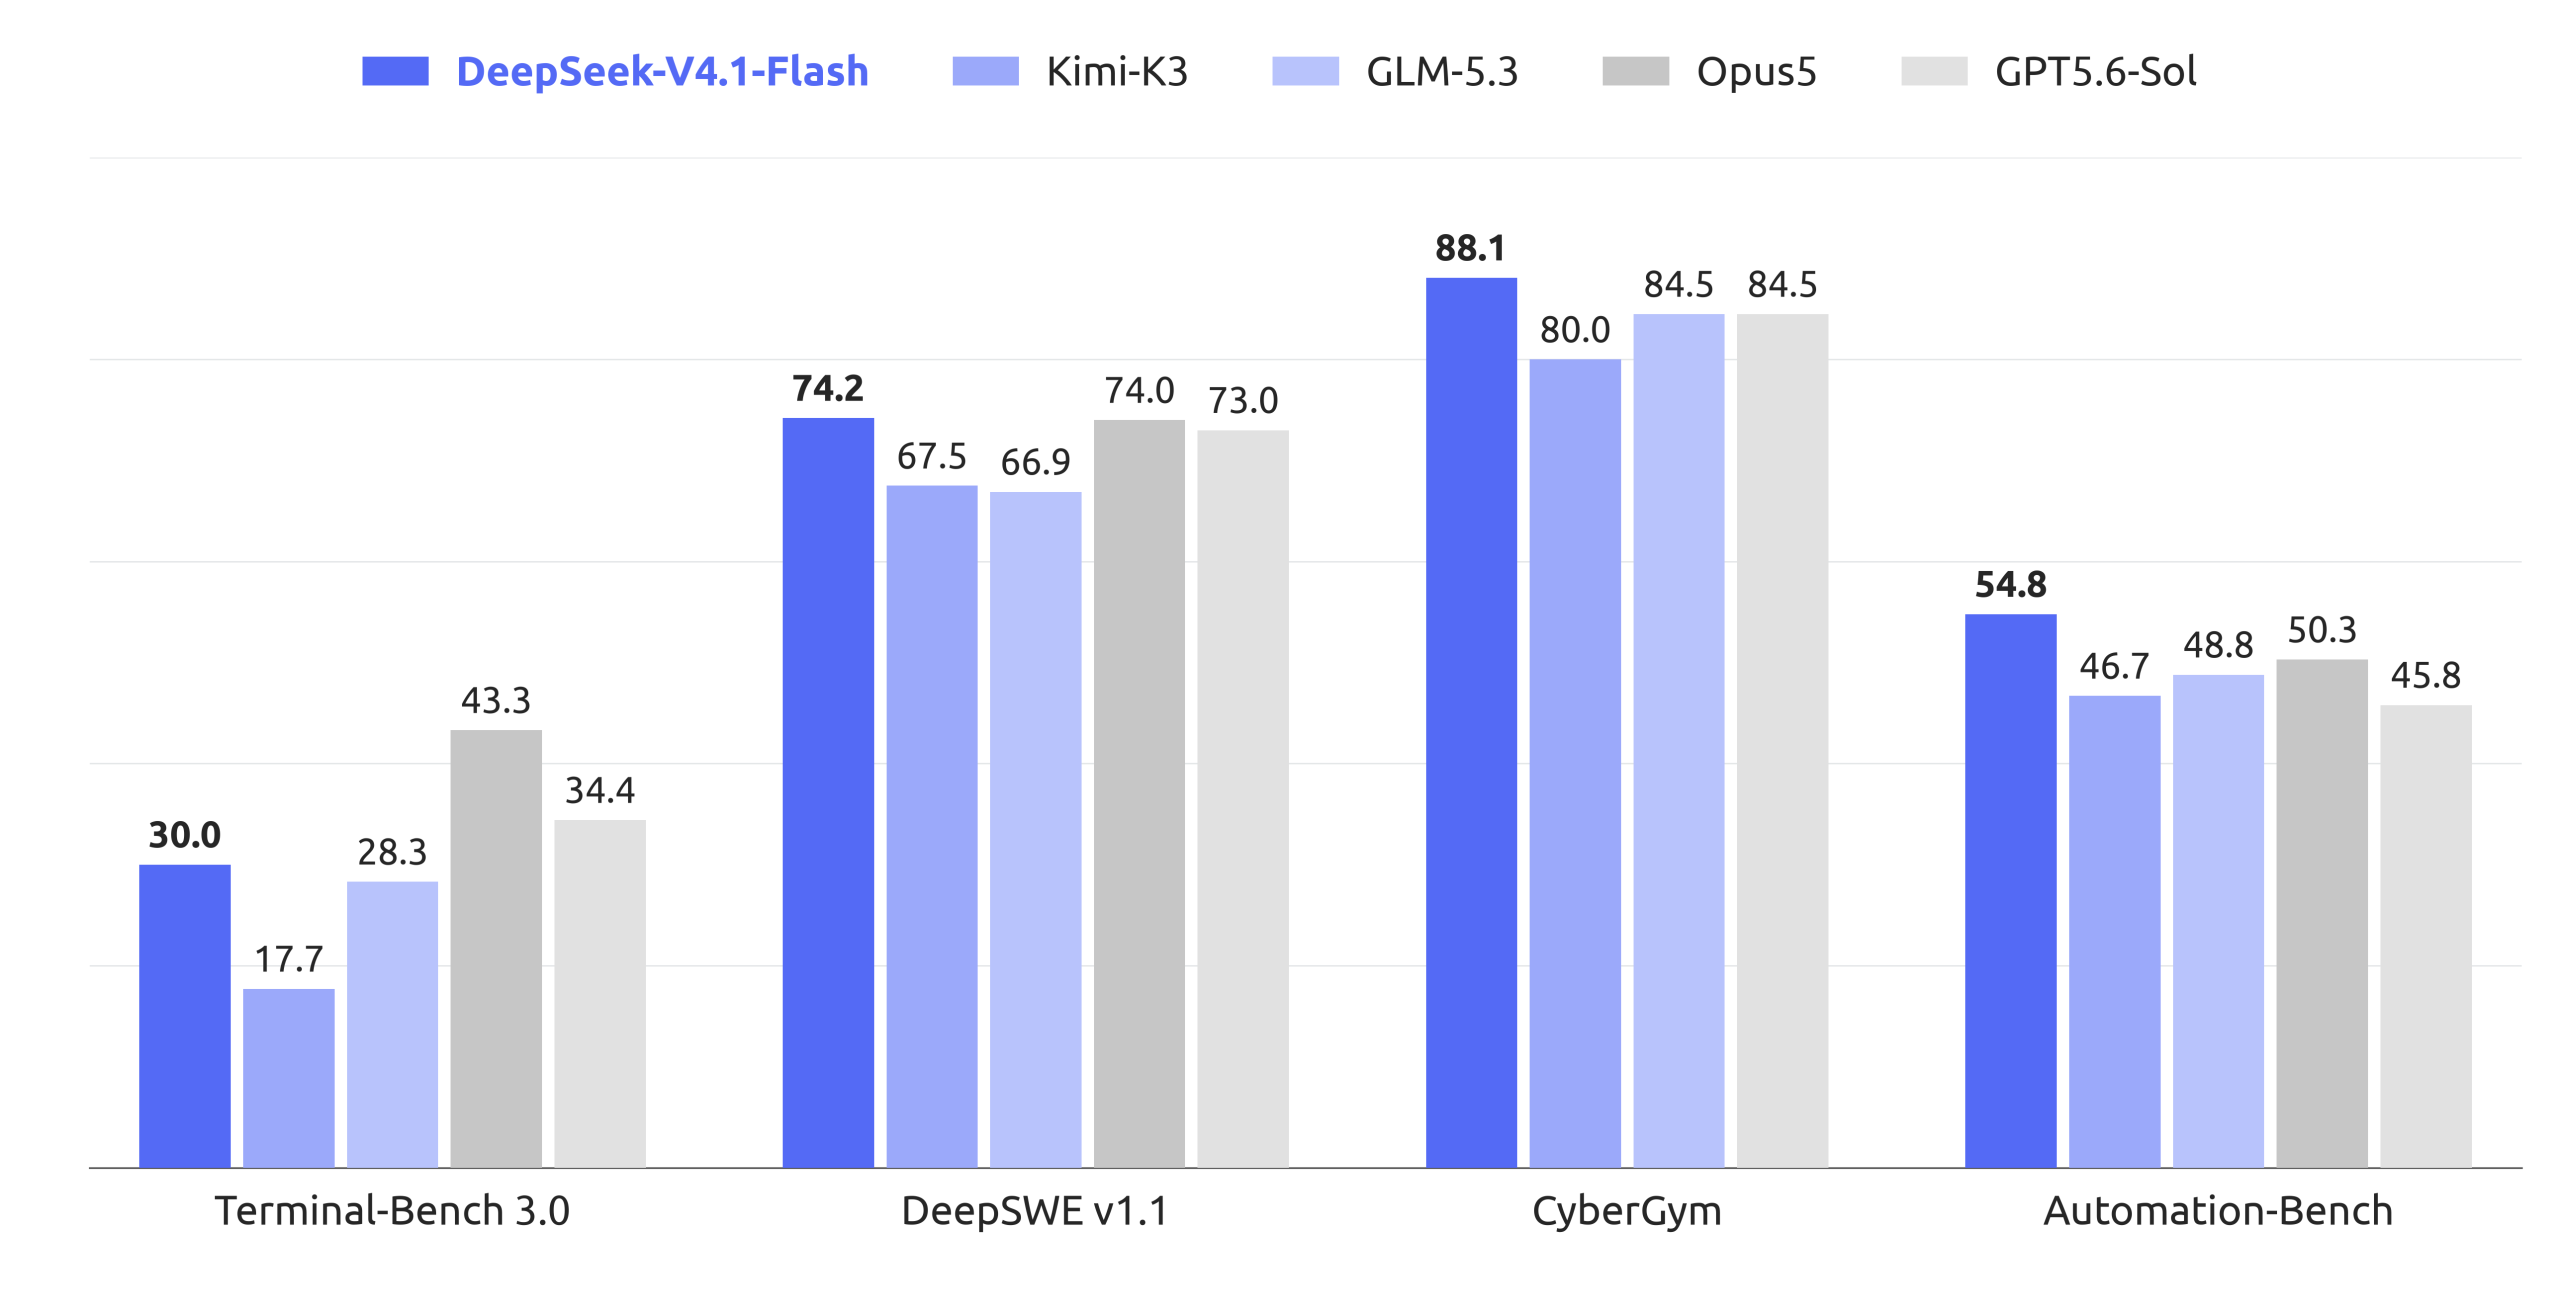
配合全新预训练方案与大规模强化学习后训练,官方测试显示,该模型在Terminal-Bench 2.1(90.6 vs 87.9)、Terminal-Bench 3.0(30.0 vs 11.8)、DeepSWE v1.1(74.2 vs 62.7)、AutomationBench(54.8 vs 43.2)等多项Agent评测中超过V4 Pro。不过需要说明,官方同时承认V4.1 Flash在知识容量维度上仍不及V4 Pro。
二、原生多模态,百万上下文 + 384K输出上限
和上一代外挂视觉模块的实验版本不同,V4.1 Flash实现底层原生多模态视觉理解,无需额外外挂模块,直接支持图片、软件界面截图、图表、图文文档的解析识别。
API层面提供充足的能力配置:支持1M token上下文窗口,最高可输出384K token内容;同时兼容思考/非思考双模式、工具调用、结构化JSON输出、Responses API,接口格式兼容OpenAI、Anthropic。此外,模型支持reasoning_effort参数(整数1–100),可连续调节推理成本与准确率之间的平衡。
三、KV Cache极致压缩:从V1到V4.1缩小437倍
对于AI智能体来说,多轮连续运行会反复复用历史上下文,KV Cache缓存开销是成本大头。V4.1 Flash在缓存压缩上实现重大突破:全局KV Cache为890 bytes/token,对比上一代V4 Flash,HBM显存占用压缩至1/4,SSD存储需求降至1/8;对比初代V1模型,KV Cache整体规模累计缩小437倍。
这一压缩由三方面协同完成:
效果上,上下文从4K拉长到1M,单token解码FLOPs只增加约四分之一,解码成本几乎不随上下文长度增长。
四、API调用规则、价格与路由变更
V4.1 Flash已正式上线DeepSeek API,开发者直接填写模型名称deepseek-flash即可完成调用。旧接口标识deepseek-v4-flash和deepseek-v4-flash-vision-exp暂时保留兼容,请求会自动路由至V4.1 Flash。腾讯WorkBuddy、CodeBuddy、OpenCode等产品已完成全量接入。
新计费规则于9月10日12:00正式生效,延续峰谷计价,闲时价格为高峰时段的一半。高峰时段为工作日9:00–12:00和14:00–18:00(北京时间),其余均为空闲时段(含周末)。具体价格如下:
| 计费项 | 空闲时段 | 高峰时段 |
|---|---|---|
| 输入(缓存命中) | 0.02元/百万token | 0.04元/百万token |
| 输入(缓存未命中) | 1.0元/百万token | 2.0元/百万token |
| 输出 | 4.0元/百万token | 8.0元/百万token |
一个重要的业务变动:自9月14日12:00起,至V4.1 Pro正式上线之前,所有指向deepseek-v4-pro的请求将全部路由转发至V4.1 Flash,并按V4.1 Flash价格计费。不过DeepSeek在9月11日又更新了说明,表示决定在9月14日之后继续提供V4 Pro模型的API调用服务,计费方式保持不变。这一动态调整值得开发者密切关注。
模型权重与51页完整技术报告已在Hugging Face以MIT许可证开源,可供开发者研究、私有化部署参考。
五、核心信息速览
552B MoE模型,CED非对称架构,40层=20层编码器+20层解码器,输入激活8B、输出激活16B,Agent基准性能超越V4 Pro(知识容量维度除外);
原生多模态,支持1M上下文、最高384K输出,兼容OpenAI/Anthropic接口格式;
KV Cache大幅压缩至890 bytes/token,HBM降至前代1/4,SSD降至1/8,较V1缩小437倍;
调用名
deepseek-flash,保留旧模型别名做兼容;V4 Pro路由规则存在动态调整,建议关注官方最新公告;峰谷双档API定价,闲时半价;模型权重与技术报告在Hugging Face以MIT许可证公开。
六、常见问题FAQ
V4.1 Flash真的全面超越V4 Pro了吗?
在Agent基准测试的多个维度(Terminal-Bench、DeepSWE、AutomationBench等)上,V4.1 Flash表现优于V4 Pro。但官方同时承认其在知识容量上不及V4 Pro。选型时需根据具体任务类型判断。
KV Cache压缩437倍是怎么算的?
437倍是初代V1模型KV Cache规模与V4.1 Flash的比值。相对于上一代V4 Flash,V4.1 Flash的HBM需求降至1/4,SSD需求降至1/8。
现有调用deepseek-v4-flash的业务需要改代码吗?
不需要。旧模型标识符暂时保留兼容,请求会自动路由至V4.1 Flash。但建议尽早将调用名称更新为deepseek-flash。
V4 Pro会被下线吗?
存在动态调整。9月10日官方计划9月14日12:00后将V4 Pro请求路由至V4.1 Flash;9月11日又更新说明,表示将继续提供V4 Pro的API服务,计费不变。建议以DeepSeek开放平台最新公告为准。
模型可以本地部署吗?
可以。模型权重已在Hugging Face以MIT许可证开源,技术报告同步公开。
参考来源:
DeepSeek官方公告及API文档
Hugging Face开源仓库:https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash
技术报告:https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash/blob/main/DeepSeek_V41_Tech_Report.pdf
免责声明:
本文信息整理自DeepSeek官方公告、开源仓库与公开媒体报道。模型能力、价格、路由规则和会员权益可能随时调整,请以DeepSeek开放平台官方页面为准。本文不构成购买建议或投资建议。
相关文章


 QQ群
 微信
 豫公网安备 41040202000300 号
评论