Kimi K2.8 Preview 全量上线 Kimi Code:百万上下文向所有会员开放,默认 Max 思考档
一、核心更新:1M Token 上下文不再只属于高阶会员
实际项目开发中,AI 编码经常面对复杂排错、多文件迭代修改等需求。例如排查登录流程故障时,往往需要同时导入前端页面源码、后端接口定义、完整报错日志,再叠加多轮沟通中形成的业务约束。随着对话持续,上传的代码文件不断增多,对模型上下文承载能力的压力也会快速上升。
K2.8 Preview 配备约 100 万 Token 超大上下文窗口,面对批量修改多份源码、超长会话延续、大型项目片段解析等高负载工作,拥有更充足的处理空间。
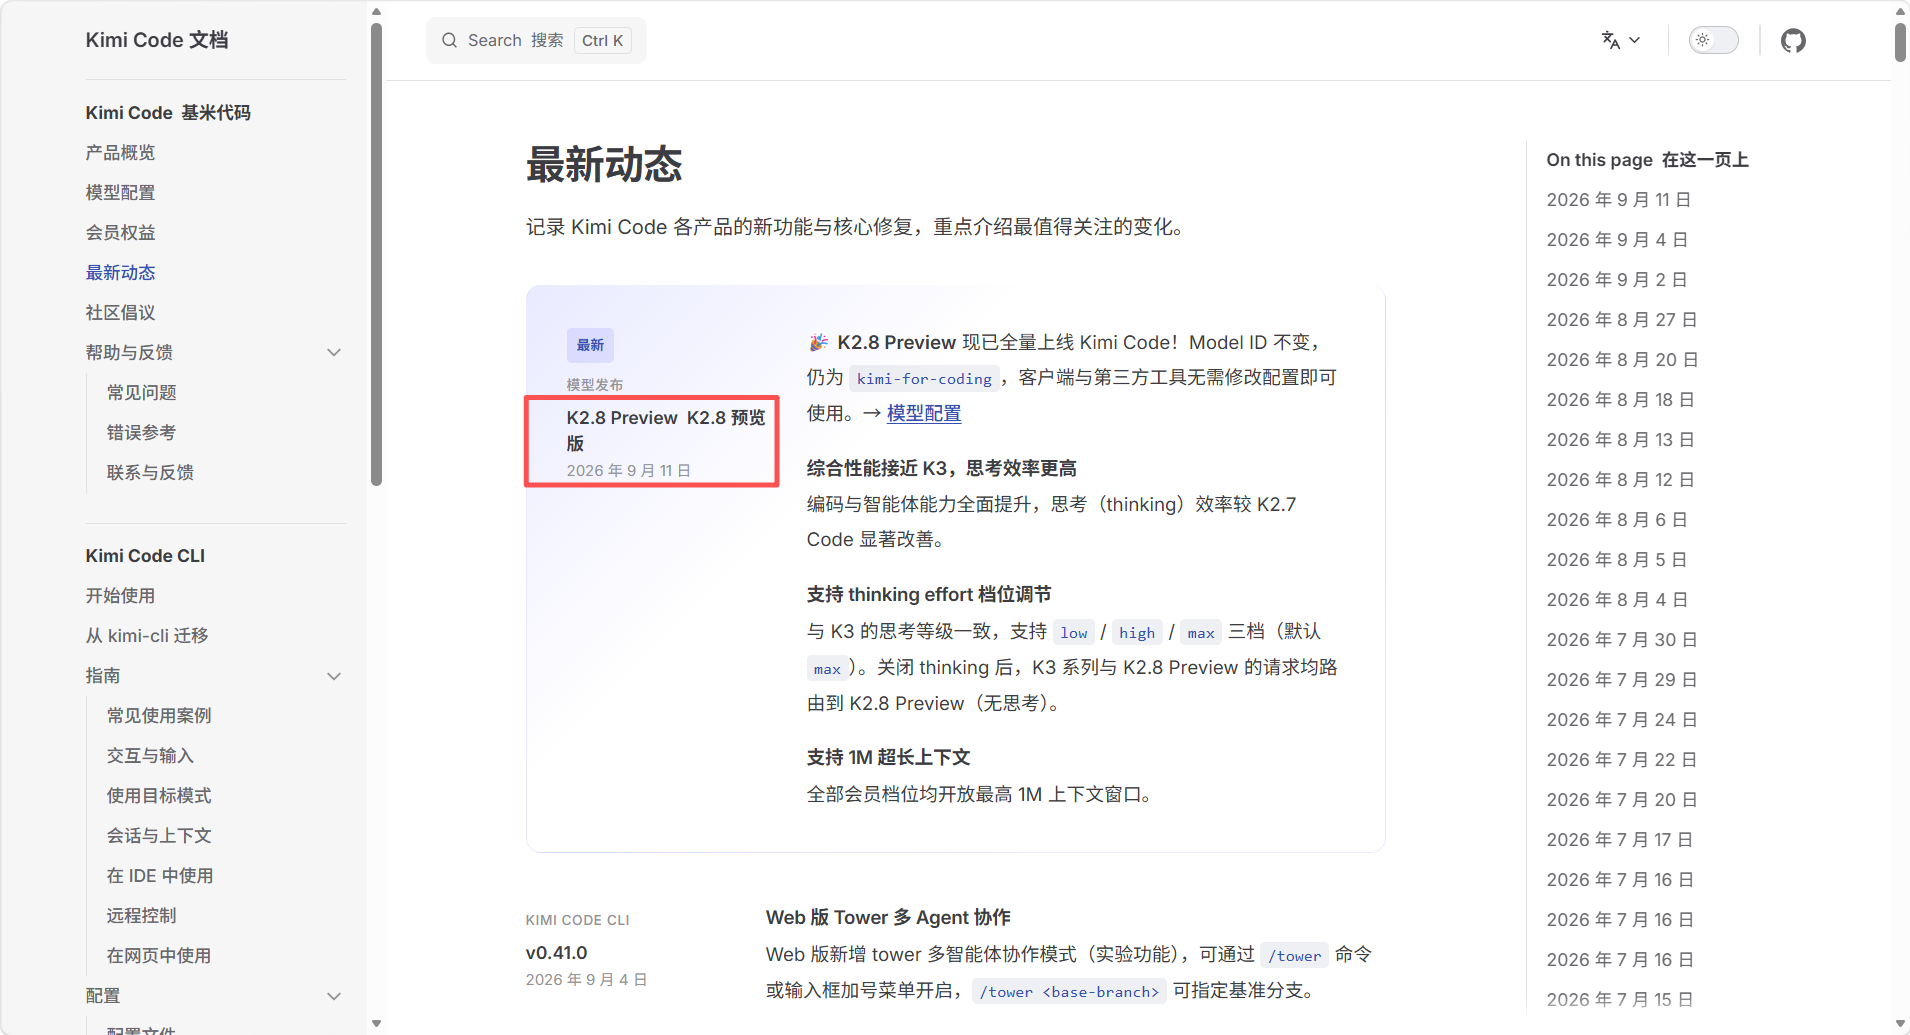
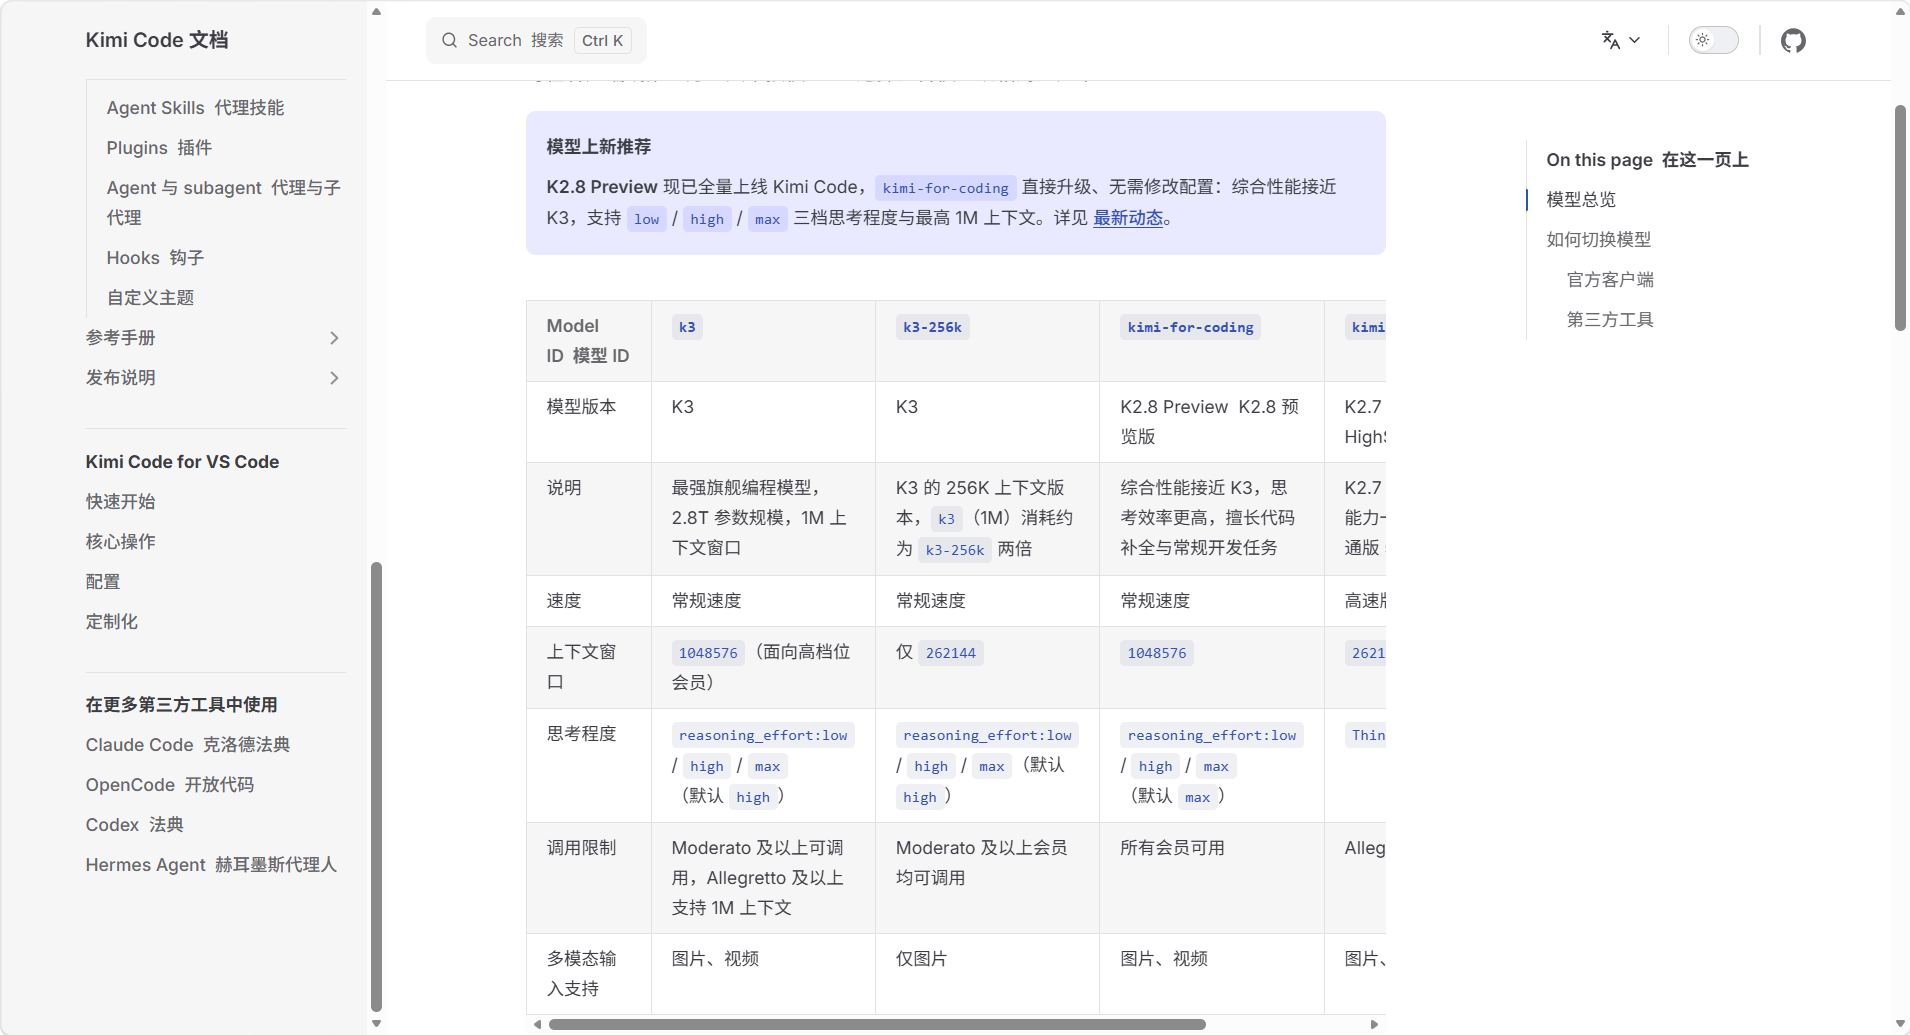
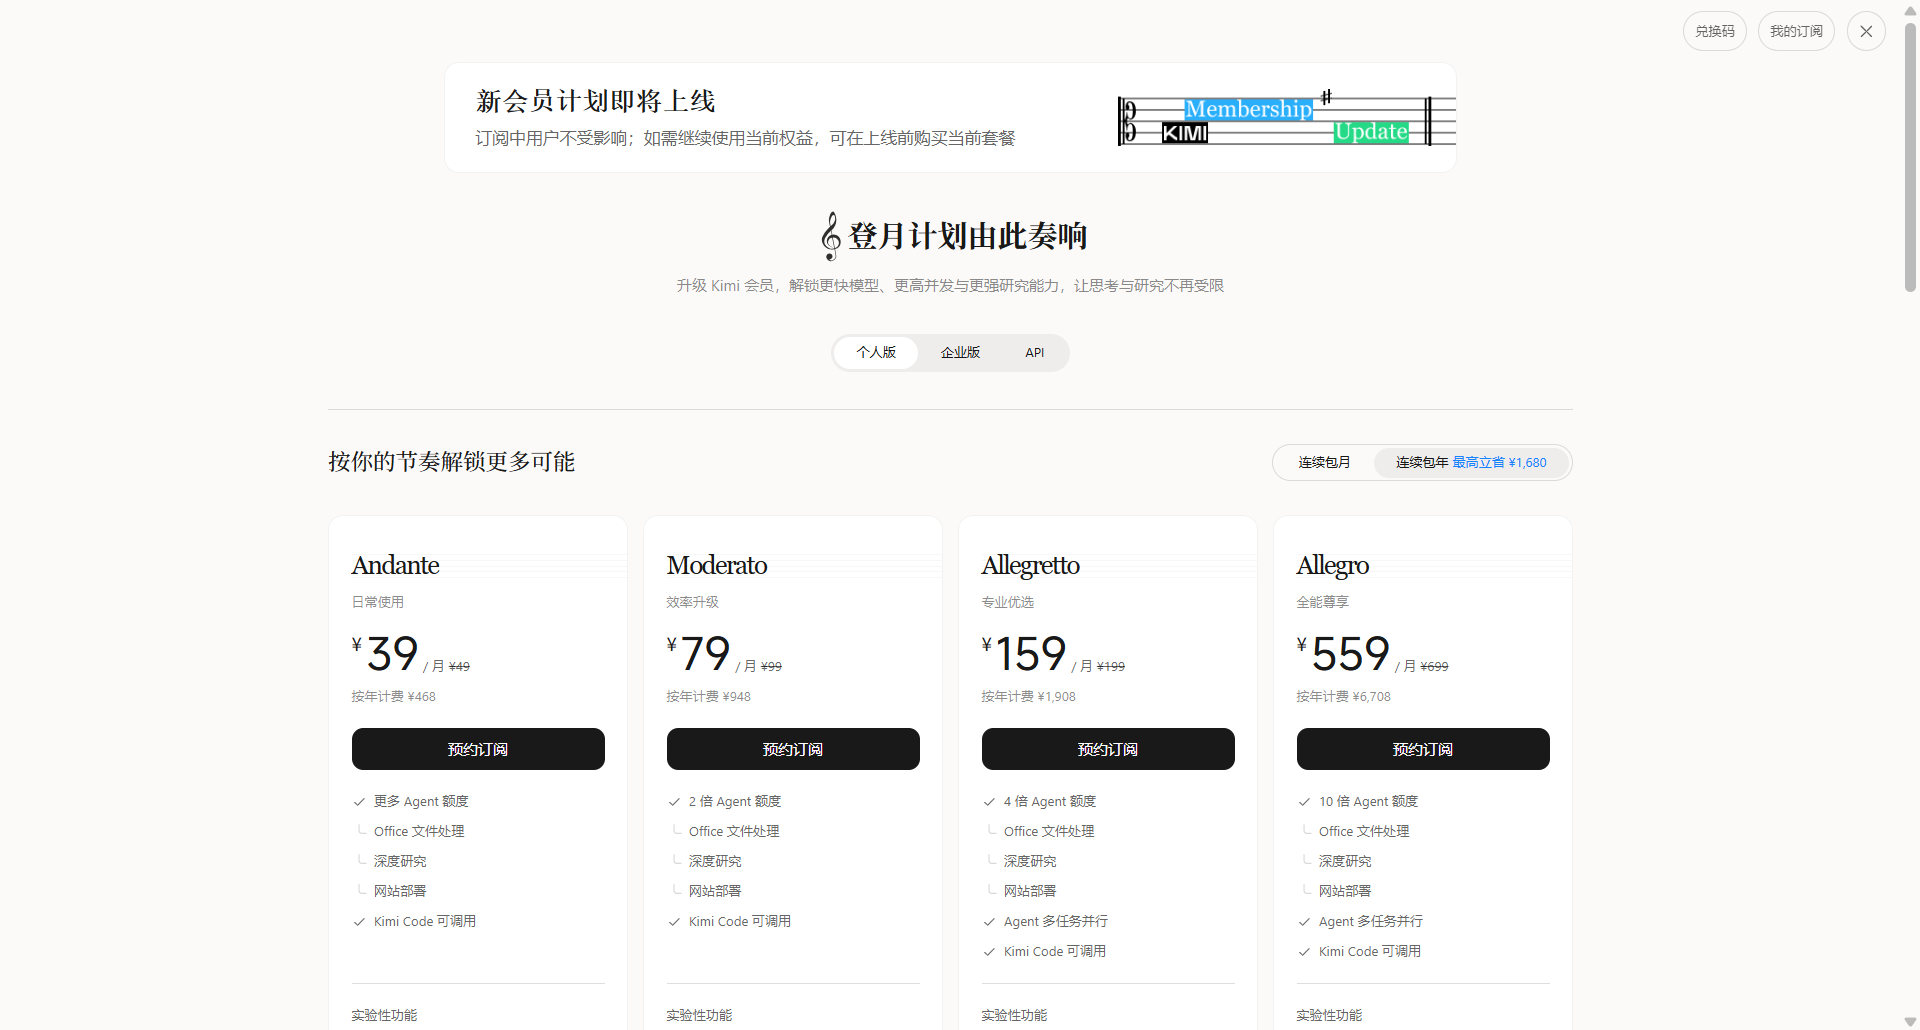
本次更新最大的亮点,是权限策略调整:1M 上下文能力不再局限于高阶付费会员,所有会员等级均可直接启用该特性。对比来看,旗舰 K3 的百万上下文功能依旧需要较高档会员权限。K2.8 Preview 直接把超长上下文的使用门槛拉低,让更多开发者可以体验大窗口编码能力。
不过需要注意:窗口大,并不代表可以不加筛选地把整套项目丢给模型。即便单次请求不会占满全部百万 Token,持续往对话里塞入大量无关代码、冗余历史聊天记录,依旧会快速消耗 Token 配额。
官方也给出了更贴合实操的建议:提前划定任务边界,只上传和当前问题强相关的资料。例如调试登录报错,仅提供报错堆栈、登录模块源码、对应接口文件就足够;等模型反馈信息缺失之后,再按需补充材料,不必一次性导入整个项目仓库。
二、三档思考模式:Low、High、Max,默认拉满推理强度
虽然归属于 K2 产品序列,但 K2.8 Preview 在编码生成、AI 智能体能力上做了重点优化,整体综合实力已经十分接近 K3 旗舰版本。对比上一代 K2.7 Code,它在代码补全、常规业务开发场景中的表现有明显进步。
目前官方还没有对外放出完整的基准评测分数,两代模型之间确切的性能差距,还需要开发者通过实际项目测试来验证。
网络上已经出现不少早期实测案例。有开发者借助 Kimi Code CLI 工具,将思考强度调至 Max 档位,让模型生成一个“鹈鹕骑自行车”的 HTML 动画。最终输出成果完整实现角色形象、自行车、道路环境与背景画面,较完整地还原了创意需求。该案例属于社区实测,并非官方基准测试。
K2.8 Preview 完整继承 K3 的三级思考调节体系,分为 Low、High、Max 三档,可供自由切换。这里有一处很有特点的细节:旗舰 K3 出厂默认是 High 推理档位,而 K2.8 Preview 开箱直接启用 Max 最高强度思考,天生更偏向处理深度复杂编码任务。不过也要留意,Max 档位会生成更多思考 Token,接口响应等待时间也会相应变长。
三、如何选型:K2.8 Preview 还是 K3?
在选型上可以遵循这样的思路:
日常函数补写、接口调整这类常规开发工作,直接使用 K2.8 Preview 就足够;
面对超高难度、需要挖掘模型能力上限的任务,再切换至旗舰 K3。
简单说,K2.8 Preview 更适合高频、长上下文、成本敏感的编码场景;K3 则仍然适合追求极限能力的高难度任务。
四、业务迁移:Model ID 不变,留意缓存失效引发的额度波动
对于已经接入 Kimi Code 做开发的用户,这次升级几乎没有改造成本。沿用现有的 kimi-for-coding Model ID 即可,原有业务配置无需任何修改,底层已经自动切换到 K2.8 Preview 模型。
如果使用 CLI 客户端,输入 /model 指令就可以查看并切换可用模型。倘若模型列表没有刷新出新版本,退出账号重新登录就能完成更新。
不少开发者更新后会察觉到 Token 消耗突然变高,这并不是模型本身存在异常。官方解释,切换不同模型之后,旧会话积累的上下文缓存会直接失效,全部对话内容需要重新解析运算,所以刚切换的阶段会出现消耗陡增的现象。
更合理的使用习惯是:体验 K2.8 Preview 时尽量开启全新会话。另外,在长会话当中,不要频繁来回切换 Low、High、Max 思考档位,档位改动同样会破坏缓存,造成不必要的资源损耗。
在 CLI 终端输入 /usage 指令,就能够实时查看额度使用情况。Kimi Code 调用额度和网页端会员权益互通共享。
五、版本号看似“倒退”,迭代判断要以更新时间为准
这次发布也在开发者社群引发有趣讨论:旗舰 K3 早已推出,新的重磅模型却命名为 K2.8 Preview,版本数字看上去反而更低。
这也给后续跟进 Kimi 产品迭代的用户提了个醒:不能单纯依靠版本数字大小去判别模型新旧,一定要结合发布时间作为核心判断依据,避免误用老旧版本。
六、更新核心要点总结
K2.8 Preview 完成 Kimi Code 全量上线,所有会员均可解锁 1M Token 超长上下文;
编码与智能体能力升级,综合性能接近 K3,默认开启 Max 最高思考档位;
兼容原有
kimi-for-coding调用标识,现有业务无需改动配置;切换模型会造成上下文缓存失效,建议新建会话使用,规避额外额度损耗;
普通开发场景优先选用 K2.8 Preview,极限复杂任务再选择 K3 旗舰。
七、常见问题 FAQ
K2.8 Preview 和 K3 怎么选?
日常开发、函数补写、接口调整、多文件排错,优先用 K2.8 Preview。若任务难度极高,或需要尽量挖掘模型能力上限,再考虑 K3。
1M 上下文等于可以上传整个项目仓库吗?
不等于。上下文窗口大,不代表应该全量投喂。无关代码和冗余历史会快速消耗 Token,也可能干扰模型判断。建议只上传与当前问题强相关的文件。
为什么切换模型后 Token 消耗变高?
切换模型后,旧会话的上下文缓存可能失效,全部对话需要重新解析运算,因此短时间内消耗会上升。建议新模型使用新会话。
现有业务需要改配置吗?
如果已经接入 Kimi Code,通常沿用 kimi-for-coding 即可,原有业务配置无需修改。CLI 用户可用 /model 查看和切换模型。
如何查看额度?
在 CLI 终端输入 /usage 即可查看。Kimi Code 调用额度与网页端会员权益互通共享。
参考来源:
Kimi Code 官方文档 What's New:
https://www.kimi.com/code/docs/kimi-code/whats-new.html
免责声明:
本文信息整理自官方文档与公开社区实测,模型能力、价格、额度、会员权益和功能可用性可能随时调整,请以 Kimi 官方页面为准。本文不构成购买建议或投资建议。
相关文章


 QQ群
 微信
 豫公网安备 41040202000300 号
评论